Clínica Santa Lucía del Norte · Tunja, Boyacá
Paciente: María Fernanda Rojas Cárdenas. C.C. 1.020.456.789. Edad: 67 años.
Historia clínica: HC-0048213. EPS: Salud Andina EPS.
Dirección: Cra 7 # 45-12, barrio La Soledad, Tunja. Teléfono: 310 555 0142.
Acompañante: Jorge Rojas Pérez (hijo), jorge.rojas@correo.co.
Ingreso: 14/03/2026. Egreso: 19/03/2026.
Paciente de 67 años con EPOC GOLD 3 e hipertensión arterial. Consulta por disnea progresiva de cinco días. Valorada por la Dra. Luisa Mejía Ortiz (RM 15-2231), quien inicia broncodilatadores y corticoide sistémico. Evoluciona con mejoría; al egreso satura 90% con oxígeno a 2 L/min.
Se solicita a Salud Andina EPS la autorización N.º 88213-4 para oxigenoterapia domiciliaria. Control el 02/04/2026 con el Dr. Andrés Villamil en consulta externa de la Clínica Santa Lucía del Norte.
Tus datos sensibles no salen del edificio.
Detecta y transforma la información personal de historias clínicas, PDFs, imágenes y audio, dentro de tu red.
Detecta, transforma y devuelve. Todo en tu sede.
Cada historia clínica es un documento de identidad.
Y el modelo que quieres usar para resumirla vive en la nube. Velo se interpone entre los dos: encuentra cada dato personal y lo transforma antes de que el texto cruce tu firewall.
- Nombre del paciente y del acompañanteNOMBRE
- Cédula, tarjeta de identidad, NITDOCUMENTO
- Número de historia y de autorizaciónHISTORIA
- Dirección con nomenclatura colombianaDIRECCIÓN
- EPS, IPS y profesional tratanteINSTITUCIÓN
- Fechas de ingreso, egreso y controlFECHA
Redacción en vivo
- Detectar
- Tokenizar
- Sintetizar
- Enviar
Una epicrisis tal como sale del sistema de historia clínica. Así la verías en un PDF.
Entiende español clínico. De Colombia.
Modelos NER entrenados en historias clínicas en español, reglas para los identificadores locales que ningún modelo genérico conoce, y una segunda pasada opcional con un LLM que corre en el mismo Nodo. Cada detección queda con tipo, posición y confianza para auditoría.
Colombia · Estados Unidos · Brasil
- Identidad
- Nombres y apellidos
NOMBRE - Cédula, TI, CE, pasaporte
C.C. 1.020.456.789 - NIT de persona o IPS
900.123.456-7 - Edad
67 años - Clínico
- Número de historia
HC-0048213 - EPS e IPS
INSTITUCIÓN - Autorización de servicio
N.º 88213-4 - Registro médico del profesional
RM 15-2231 - Contacto
- Dirección
Cra 7 # 45-12 - Barrio y municipio
UBICACIÓN - Celular y fijo
310 555 0142 - Correo
CORREO - Tiempo
- Fechas numéricas
14/03/2026 - Fechas en texto
2 de abril - Financiero y digital
- Tarjetas y cuentas
PAN, IBAN - IP, URL, usuario
DIGITAL - A la medida
- Tus propios tipos: códigos internos, nombres de sedes, consecutivos
PERSONALIZADO - Se entrenan con ejemplos anotados desde la interfaz, sin equipo de ciencia de datos
UI
Seis formas de tratar cada dato. Por tipo de entidad.
Elige una política por entidad y por proyecto: el nombre se sintetiza, la fecha se desplaza, la cédula se tokeniza.
| Modo | Qué hace | Ejemplo |
|---|---|---|
| Redactar | Reemplaza por la etiqueta del tipo. | María F. Rojas → [NOMBRE] |
| Tokenizar | Token consistente en todo el documento, reversible con la bóveda local. | María F. Rojas → NOMBRE_1 |
| Sintetizar | Valor realista del mismo tipo y formato; el texto sigue leyéndose natural. | María F. Rojas → Clara I. Montoya |
| Desplazar fechas | Un mismo desplazamiento por paciente: los intervalos clínicos se conservan. | 14/03 → 08/04 |
| Generalizar | Edad a rango, municipio a departamento, para bajar el riesgo de re-identificación. | 67 años → 65 a 69 |
| Cifrar con formato | Cifrado que preserva el formato, reversible solo con tu llave. | 1.020.456.789 → 7.315.902.144 |
Entra cualquier archivo. Sale limpio.
Sale en el mismo formato, o en Markdown y JSON listos para RAG, fine-tuning y analítica.
- Entrada
- Nativo o escaneado, con OCR local
- Salida
- PDF nuevo sin capa de texto oculta, metadatos ni adjuntos
Office
- Entrada
- DOCX, PPTX, XLSX
- Salida
- El mismo archivo, con la estructura y los estilos intactos
Datos
- Entrada
- CSV, JSON, XML, HTML, texto plano
- Salida
- Campos libres limpios; columnas estructuradas por política
Imágenes
- Entrada
- PNG, JPG, TIFF, fotos de fórmulas y órdenes
- Salida
- Texto detectado por OCR y cubierto en el píxel
Audio
- Entrada
- WAV, MP3, llamadas del call center
- Salida
- Transcripción local, silencio sobre cada segmento sensible
Correo
- Entrada
- EML y MSG, con adjuntos
- Salida
- Cuerpo y adjuntos procesados en una sola pasada
Por lotes desde una carpeta o un bucket, o documento por documento vía API. El mismo motor en los dos casos.
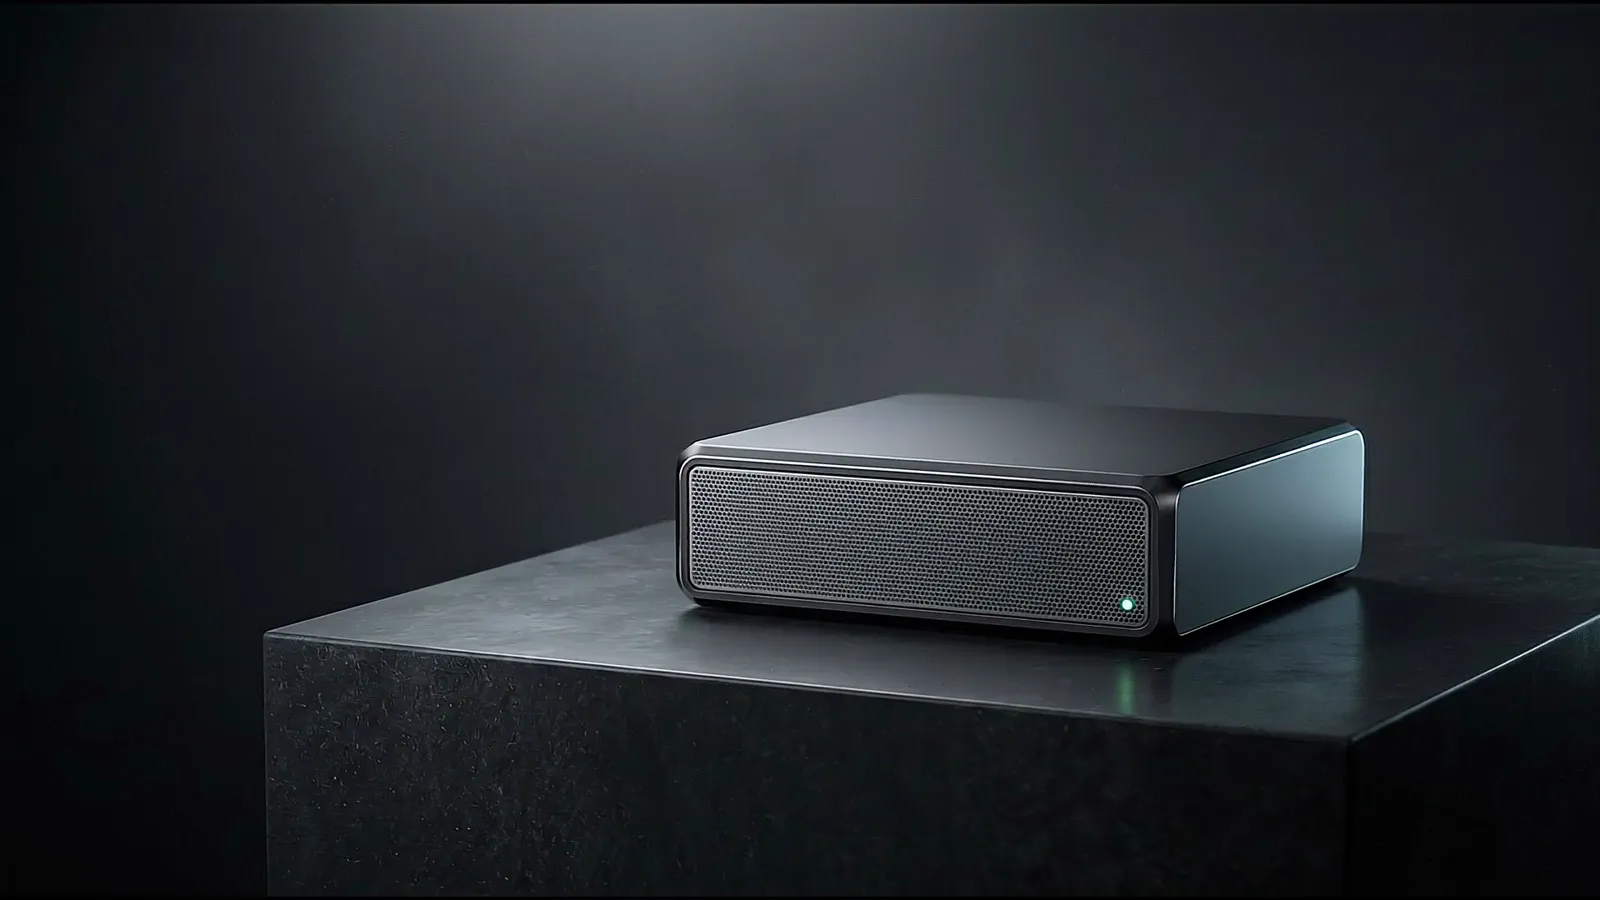
Velo Nodo.
Un computador de IA del tamaño de un libro. Lo conectas a tu red, arranca sin internet y procesa tus documentos en la sede.
- Memoria
- 128 GB unificada CPU + GPU
- Disco
- 4 TB NVMe, cifrado en reposo
- Red
- 2 × 10 GbE, modo air-gapped
- Tamaño
- 15 × 15 × 5 cm
- Licencia
- Validación offline, sin llamadas externas
Especificaciones de referencia, sujetas a cambio.
¿Ya tienes servidores? Velo Motor se instala en tu clúster con Docker o Kubernetes, en x86 o ARM, con GPU NVIDIA de 16 GB o solo con CPU.
Se conecta a lo que ya tienes.
API REST y SDK de Python para tus pipelines, interfaz web para quien revisa, y conectores para leer y escribir donde ya viven tus documentos.
from velo import Motor

motor = Motor("https://velo.intranet")   # tu Nodo, dentro de tu red
doc = motor.procesar("epicrisis_0048213.pdf",
                     modo="tokenizar", idioma="es-CO")

respuesta = llm.generar(doc.texto)          # el modelo solo ve tokens
print(motor.rehidratar(respuesta, doc.boveda))
Conectores
- Amazon S3
- Azure Blob
- Google Cloud Storage
- SharePoint
- Carpetas SMB y NFS
- SFTP
- API REST
Gobierno
- Roles y permisos por proyecto, SSO con SAML u OIDC
- Bitácora de auditoría de cada detección y cada re-hidratación
- Revisión humana por muestreo desde la interfaz
- Recall por tipo de entidad medido sobre tu propio set de validación
Marco regulatorio
- HIPAAEE. UU.
- GDPRUnión Europea
- LGPDBrasil
- Ley 1581Colombia
- Res. 1995Colombia
Diseñado para apoyar el cumplimiento de estos marcos. No son certificaciones ni sellos oficiales.
Pseudonimizar no es anonimizar. Si existe una bóveda que permite revertir, lo que viaja sigue siendo dato pseudonimizado. Te ayudamos a documentar el control ante tu comité y a combinarlo con retención cero y DPA de tu proveedor de nube.
Semanas 1 a 3
POC en tu sede
Con 100 a 200 PDFs reales de tus fuentes más frecuentes, anotados a mano, medimos recall por tipo de entidad.
A la medida
Ajuste a tu HCE
Reglas por formato de exportación (Servinte, SAP, Dinámica Gerencial y otros) y entidades propias de tu institución.
Producción
Nodo o clúster
Instalamos el Nodo o el Motor en tu infraestructura, con soporte 8×5 o 24×7 y actualizaciones de modelo sin conexión.
Usa el modelo que quieras. Nunca conocerá a tu paciente.
Tu redNube
Entraepicrisis_0048213.pdf · 3 páginas
Sale al modelo[NOMBRE_1], [EDAD_1], EPOC GOLD 3, disnea de cinco días. ¿Plan de egreso?
RespondeOxigenoterapia domiciliaria para [NOMBRE_1]; control en dos semanas.
Re-hidratado en tu redOxigenoterapia domiciliaria para María Fernanda Rojas Cárdenas; control en dos semanas.
La bóveda nunca sale del Nodo. El proveedor de la nube recibe tokens o sustitutos; la respuesta vuelve con tus datos reales solo dentro de tu red.
Pruébalo con tu propio texto.
Pega una nota. Se procesa en tu navegador con reglas de demostración; no se envía nada a ningún servidor. El producto usa modelos NER, no solo reglas.
Mídelo con tus PDFs.
Un POC en tu sede, con tus documentos, sin que nada salga de tu red. Al final tienes el recall por tipo de entidad y un informe para tu comité.
- HIPAAEE. UU.
- GDPRUnión Europea
- LGPDBrasil
- Ley 1581Colombia
Diseñado para apoyar el cumplimiento.
Preguntas frecuentes
¿Qué es Velo?
Velo es un software de detección y anonimización de datos personales (PII) para texto clínico que corre on-premise: en el Velo Nodo, un computador de IA compacto, o en tu propio clúster. Procesa historias clínicas, PDFs, imágenes y audio sin que los datos salgan de tu red.
¿Mis datos salen de mi red?
No. La detección, la transformación y la bóveda de reversión ocurren dentro de tu infraestructura. Si decides usar un modelo en la nube, solo viaja el texto tokenizado o sintetizado, y la respuesta se re-hidrata localmente.
¿Pseudonimizar es lo mismo que anonimizar?
No. Si existe una bóveda que permite revertir los tokens, el dato sigue siendo pseudonimizado y sigue sujeto a la regulación de datos personales. La anonimización exige que la re-identificación no sea razonablemente posible, y eso se mide.
¿Qué mercados e identificadores cubre?
Colombia (cédula, número de historia, EPS, direcciones con nomenclatura local), Estados Unidos (SSN, MRN, member ID, NPI, ZIP) y Brasil (CPF, Cartão SUS, prontuário, CRM, CEP), además de nombres, fechas, teléfonos, correos e instituciones.
¿Qué formatos procesa?
PDF nativo y escaneado con OCR local, DOCX, PPTX, XLSX, CSV, JSON, XML, HTML, imágenes, audio y correo con adjuntos. La salida puede ser el mismo formato o Markdown y JSON listos para RAG.
¿Cómo empiezo?
Con un POC de una a tres semanas en tu sede, sobre 100 a 200 documentos reales anotados a mano. Al final tienes el recall por tipo de entidad y un informe para tu comité de privacidad.